Web sitelerinin arama motorları tarafından taranması, içeriklerin arama sonuçlarına dahil edilmesi ve sayfaların keşfedilmesi açısından teknik SEO çalışmaların çok önemli bir parçasıdır. Bu süreç içerisinde kullanılan araçlardan biri de robots.txt dosyasıdır.
Robots.txt, web sitesini ziyaret eden arama motoru tarayıcılarına hangi URL yollarını tarayabileceklerini ya da taraması gerektiğini bildiren metin tabanlı bir dosya çeşididir. Bu dosya sayesinde site yöneticileri tarama erişimi ile alakalı belli kurallar tanımlayabilir.
Ancak robots.txt dosyasının en temel görevi, bir sayfanın Google’da önemli şekilde görünmesine engel olmak değildir. Bu yüzden robots.txt ile noindex gibi farklı mekanizmaların görevleri birbiriyle karıştırılmamalıdır. Doğru yapılandırılan bir robots.txt özellikle çok sayfalı, büyük ya da filtreleme sistemleri bulunan web sitelerinde tarama yönteminin çok daha kontrollü yapılmasına yardımcı olur.
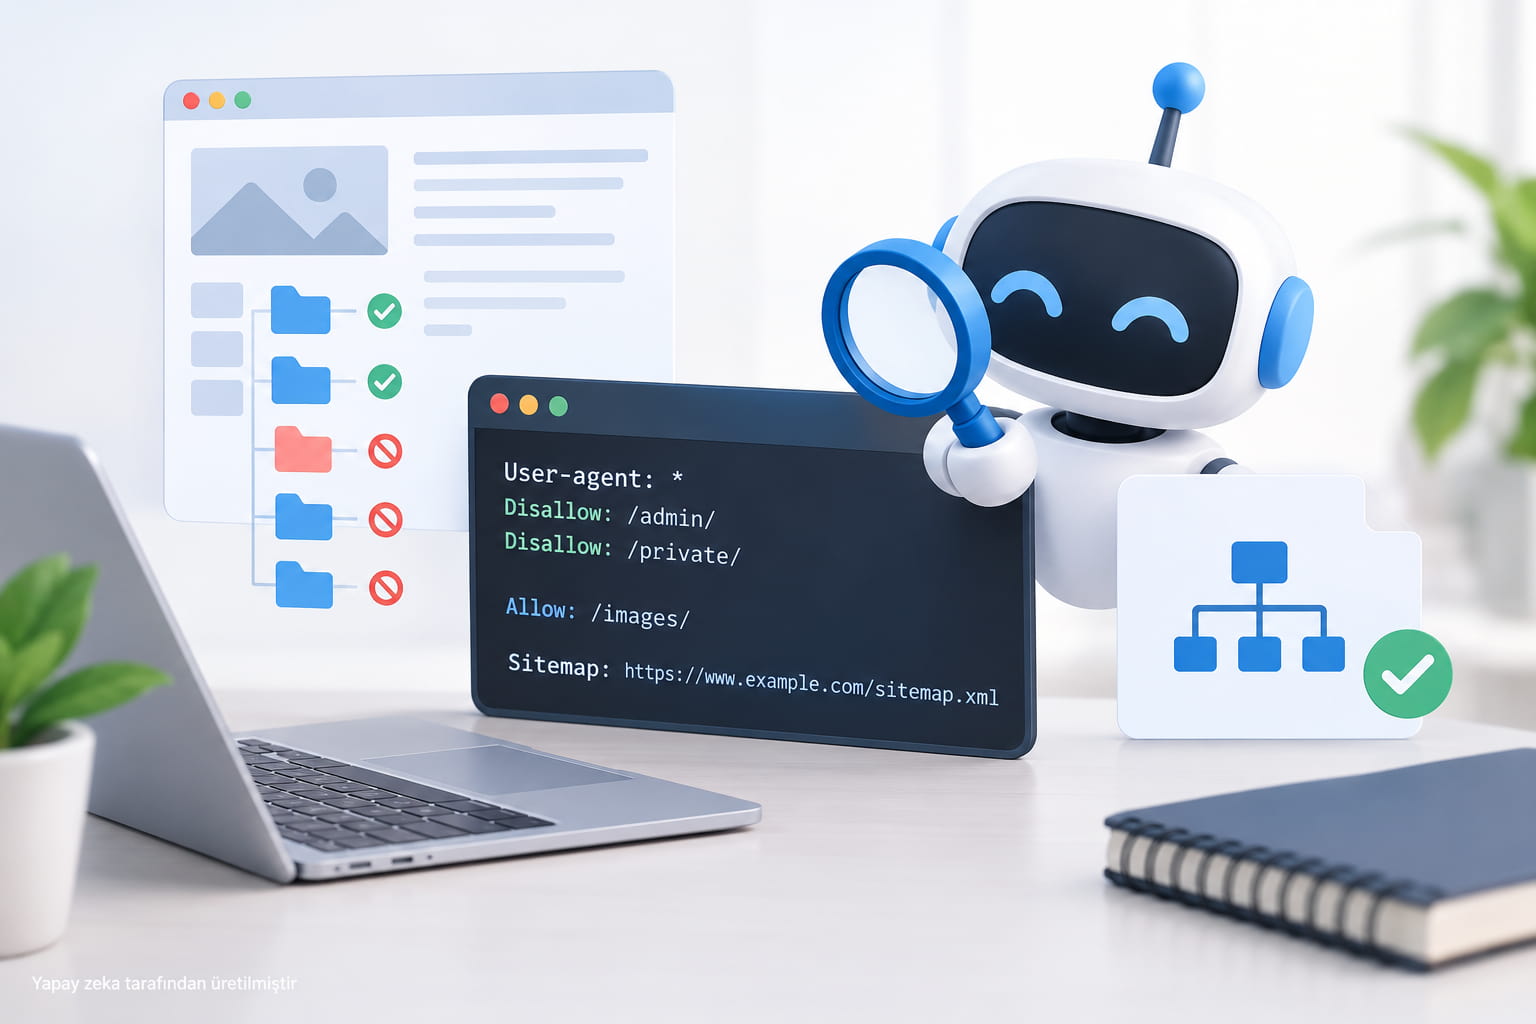
Robots.txt dosyasının temel işlevi; tarayıcıların web sitesindeki hangi URL’lere erişebileceğini belirtmektir. Google’ın dokümantasyonunda da robots.txt, tarayıcıların bir sitenin herhangi bölümünü tarayabileceğini belirleyen kurallar içeren bir dosya şeklinde açıklanır. Örnek vermek gerekirse; bir sitenin /admin/ yolundaki, URL’lerin taranmasını isteyen bir site yöneticisi ilgili yolun Disallow kuralıyla belirtilebilir:
User-agent: * Disallow: /admin/
Buradaki User-agent: * kuralı tüm tarayıcıları içine alırken Disallow /admin/ ifadesi, /admin/ yolu altındaki URL’lerin taranmasına engel olmak için kullanılır.
Robots.txt dosyası sadece tarama erişimiyle alakalı olabilir. Ayrıca dosyanın geçerli olması için web sitesinin üst düzey dizininde ve yeni alan isminin kök dizininde bulunması şarttır. Örnek vermek gerekirse: bu geçerli bir konumken https://www.example.com/blog/robots.txstandart robots.txt konumu değildir.
Robots.txt SEO açısından neden önemlidir? Sorusunun cevabı, direk sıralama artışı olarak verilmemelidir. Robots.txt kullanmak yalnız başına bir web sitesinin artama sonuçlardaki sıralamasını yükseltmez. Dosyanın temel işlevi arama moturu tarayıcılarının site içerisindeki URL’lere ulaşmasını kurallarla yönetmektir.
Bir web sitesinde arama motorlarının taramasına gerek bazı URL ya da dizinler bulunabilir. Robots.txt, bu alanlara dair tarama erişimini belli kurallarla sınırlandırmak amacıyla kullanılabilir. Örnek vermek gerekirse; yönetim paneli gibi arama sonuçlarında bulunmasını hedefleyen bir yol için tarama kısıtlaması tanımlanabilir. Bu noktada önemli olan gerçekten taranmasına gerek duyulmayan alanların doğru şekilde belirlenmesidir.
Bazı sitelerde çok sayıda teknik ya da benzer URL oluşabilir. Özellikle sıralama, filtreleme ve parametre kullanımı bulunan yapılarda aynı içeriğe yakın çok sayıda URL ortaya çıkabilir. Uygun durumlarda robotx.txt kuralları bu URL ‘lerin taranmasını sınırlandırılmasına yardımcı olabilir.
Ancak her parametre için URL’nin otomatik şekilde robots.txt ile engellenmesi doğru bir tutum değildir. İlk olarak URL’lerin site içerisindeki işlevi ve arama motorlarının bunlara erişmesine duyulan ihtiyaçlar değerlendirilmelidir.
Filtre, ürün, kategori ve farklı içerik çeşitlerinin bulunduğu büyük web sitelerinde URL sayısı çok fazla olabilir. Robots.txt tarayıcıların belli URL yollarına erişimini sınırlandırarak tarama sürecinin çok daha kontrollü yönetilmesinde rol oynanabilir. Bu durum özellikle çok sayıda teknik URL üreten sitelerde daha fazla önem teşkil edebilir.
Filtreleme sistemleri ya da e-ticaret siteleri kullanılan web sitelerinde renk, marka, beden, sıralama gibi seçeneklerle birbirinden farklı URL’ler oluşabilir. Bu URL’lerin tamamının arama motorları tarafından taranması her zaman gerekli değildir.
Robots.txt bu gibi durumlarda kullanılabilecek araçlardan biridir. Ancak hangi URL’lerin engellenileceğine karar verirken söz konusu URL’lerin kullanıcı ihtiyacı, SEO değeri ve sitenin teknik yapısı birlikte değerlendirilmelidir.
Robots.txt oluşturma işlemi temel olarak bir metin dosyası hazırlamak ve içermesi gereken kuralları dahil etmekten oluşur. Google’ının dokümantasyonuna göre dosya düz metin şeklinde hazırlanmalı ve sitenin kök dizinine yerleştirilmelidir. Buna bağlı olarak :
Robots.xtst içerisinde en sık kullanılan komutlar User-agent, Disallow, Allove Sitemap alanlarıdır. Google aynı zamanda URL yollarında sınırlı şekilde *ve $ joker karakterine destek olur.
User- agent: *
Buradaki yıldız işareti tüm tarayıcıları ifade etmek için kullanılır.
Disallow: /admin/
Bu kural /admin/ yolu altındaki URL’ler için yarama kısıtlaması oluşturur.
Allow: /admin/ public/
Bu gibi bir kural daha geniş bir engelleme kuralı içerisinde belli bir yolun erişebilir bırakılması gereken durumlarda tercih edilebilir.
Sitemap: https://www.example.com/sitemap.xml
Sitemap sabit belli bir user-agent grubuna bağlı değildir ve tam URL ile belirtilmelidir.
PDF uzantısı ile eşleşen yolların taranmasını sınırlandırmak için kullanılabilir.
Bu kullanım URL’nin .pdf ile bitmesini temel alır. Joker hareketlerin kullanımında URL eşleşme kurallarının doğru şekilde anlaşılması önemlidir.
Robots.txt ile belli dosya yolları, dizinler ya da URL desenleri için tarama kısıtlamaları oluşturulabilir. Örneğin belirli teknik klasörler, yönetim alanları ya da taranmasına gerek görülmeyen bazı URL grupları için kuralla tanımlanabilir.
Bununla beraber robots.txt ile engelleme bir URL’nin kendisi mutlaka Google arama sonuçlarından tamamen kaybolmaz. Google’ının açıklamasına göre, taranması engellenen bir URL’nin içeriği taranmadığı halinde URL’nin kendisi başka yollarla keşfedilirse arama sonuçlarında gösterilmesi mümkün hale gelebilir.
Robots.txt, tarayıcılarla belli URL yollarını taramaları yönünde kural oluşturur. Noindex ise bir sayfanın aram sonucuna dahil edilmemesi için kullanılan bir dizine ekleme kontrolüdür.
Bu yüzden sadece bir sayfanın Google’da görünmesini istemediğiniz için robots.txt ile sayfayı engelleme doğru bir çözüm değildir. Google’ın sayfayı doğru şekilde değerlendirilebilmesi için sayfanın taranabilir olması gereken durumlar bulunabilir. Kısacası robots.txt daha çok tarama erişim, noindex ise dizine ekleme tarafıyla alakalıdır.
Robots.txt basot bir metin dosyası olsa bile yanlış bir kural sitenin taranma şeklini etkileyebilir. En fazla karşılaşılan hatalar şu şekilde sıralanabilir:
Bu yüzden dosyada gerçekleştirilecek değişikler özellikle büyük sitelerde yayına alınmadan önce dikkatli şekilde kontrol edilmelidir:
Robots.txt, arama motoru tarayıcılarına web sitesinde hangi URL yollarını tarayabileceğini ya da taramalarını gerektiğini bildiren metin tabanlı bir dosya şeklidir.
Web sitesinde tarama erişimini belli kurallarla yönetmeye fayda sağlar. Özellikle belli URL yollarının taranmasının sınırlandırılması amacıyla kullanılabilir.
Robots.txt adında düz metin dosyası oluşturulur. İçerisine User- agent, Disallow, Allow ve gerekiyorsa Sitemap kuralları dahile edilir. Sonrasında dosya sitenin kök dizinine yüklenir.
Dosya, web sitesinin kök dizinine yüklenmelidir. Örneğin: https://www.example.com/robots.txt adresine erişebilir olması şarttır.
Hayır. Robots.txt temel olarak tarama erişimini yönetir. Bir URL'nin dizine dahil edilip edilmesini değerlendirmek için farklı araç ve kontroller kullanılmalıdır.
Robots.txt direk sıralama artıran bir SEO yöntemi değildir. Ancak tarama erişiminin yönetilmesinde rol oynadığı için teknik SEO açısından oldukça önemlidir.
Robots.txt tarama erişimini sınırlandırırken noindex, sayfanın arama sonuçlarına eklenmemesi için kullanılan bir direktiftir. İki mekanizmanın amacı birbirinden farklıdır.
Robots.txt yalnız başına bir URL’nin Google arama sonuçlarında kesin şekilde görünmemesini garanti etmez. Tarama engellenen bir URL, başka yollarla keşfedilirse arama sonuçlarında URL olarak görülebilir.
İlk olarak alamadiniz.com/robots.txt adresinde dosyanın erişilebilir olduğu mutlaka kontrol edilmelidir. Sonrasında oluşturulan kuralların hedeflenen URL’lerle doğru şekilde eşleştiği incelenmelidir.
Evet. Sitemap adresi robots.txt içerisinde Sitemap: alanıyla ifade edilebilir. Tam ve geçerli sitemap URL’si kullanılmalıdır.
Disallow belirmene user-agent için belli, bir URL yolunun taranmasına engel olmak amacıyla kullanılabilir.
User- agent, bir robots.txc kuralının hangi tarayıcıda ya da tarayıcı grubunda uygulanacağı belirtilir. User- agent: * kullanıldığında kural tüm tarayıcıları içerisine alır.
Hatalı bir kural önemli URL’ lerin taranmasının önüne geçilmesine ya da istenmeyen URL’lerin taramaya devam etmesine sebep olabilir. Bu yüzden robots.txt farklılıkları yayına alınmadan önce dikkatli şekilde kontrol edilmelidir.